22 pont az AI-ügynök tesztünkön — és amit szándékosan nem javítottunk ki
Lefuttattuk a saját oldalunkon az isitagentready.com „AI-ügynök felkészültség" tesztjét. 22 pontot kaptunk, 12 hiánnyal. Hármat kijavítottunk, kilencet szándékosan nem — plusz megcsináltunk két olyan dolgot, ami nem is volt a listán, és ami többet ér az egésznél. Menet közben az is kiderült, hogy a teszt egy ponton nem az oldalunkat mérte. A végén 40 pont lett belőle („Level 4 — Agent-Integrated"), és pontosan tudjuk, miért nem lesz több. Ez a bejegyzés végigmegy mind a tizenketten, és megindokolja mindegyik döntést.
Előrebocsátom: nem a tesztet akarom leszólni. Hasznos eszköz, és pont azt csinálja, amit egy ilyen eszköz csinálni tud — végigkérdez egy listát. A saját súgója is kiírja, hogy a javaslatai gépi úton készülnek, és érdemes szakmailag mérlegelni őket, mielőtt bármit megvalósítasz. Mi pontosan ezt tettük. Az eredmény: a lista fele hasznos volt, a másik fele kifejezetten ártott volna.
Mi ez az egész, és miért most
Az elmúlt években a weboldaladat emberek és keresőrobotok olvasták. Most belépett egy harmadik olvasó: az AI-ügynök. Egy ChatGPT, egy Perplexity, egy Claude — vagy éppen egy ügynök, ami a felhasználód nevében keres szolgáltatót. Ezek nem úgy olvasnak, mint a Googlebot: nem indexelni akarnak, hanem választ adni, és ehhez gyorsan és félreértés nélkül el kell dönteniük, hogy ki vagy, mit csinálsz, és mit szabad a tartalmaddal.
Erre az igényre több szabvány-kezdemény is született az elmúlt hónapokban. Van köztük kiforrott és van köztük olyan, ami még IETF-vázlat, nulla valós használóval. A tesztek — esetünkben az isitagentready.com, ami öt kategóriában, összesen tizenhat ellenőrzéssel pontoz — viszont nem tesznek különbséget: mindent hiánynak jelölnek, ami nincs fent. Innen jön a 22 pont — és innen jön az a kísértés, hogy az ember feltoljon egy csomó fájlt, csak hogy zöld legyen a lámpa.
Az alapszabály, amihez tartottuk magunkat: ezek a fájlok nem pontszámok, hanem szerződések. Ha kiteszel egy katalógust arról, hogy van API-d, akkor az ügynök el fogja hinni, meg fogja hívni, és el fog bukni. Nem létező szolgáltatást hirdetni rosszabb, mint semmit sem hirdetni: az előbbi hibás rendszernek mutat, az utóbbi csak szűkszavúnak.
Amit megcsináltunk
1. Content Signals a robots.txt-ben
Ez a legjobb ár-érték arányú pont a listán. Egyetlen sor a robots.txt-ben,
ami háromféle felhasználásról nyilatkozik külön-külön:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Magyarul: keresőindexbe mehet (jöjjön a látogató), AI-válaszhoz forrásként felhasználható (idézzenek minket, ez ma a megtalálhatóság fele), de modell tanítására nem. Ez a három külön kapcsoló pont azért fontos, mert a legtöbben itt rontják el: vagy mindent kitiltanak — és akkor az AI-válaszokban soha nem jelennek meg —, vagy mindent beengednek.
Egy fontos kiegészítés, amit a teszt nem kért, de e nélkül féllábas lenne a dolog. A
Google-Extended és az Applebot-Extended nem robotok, hanem
robots.txt-tokenek: nincs saját látogatójuk, akit tűzfallal ki lehetne szűrni.
Csak ebben a fájlban lehet nemet mondani nekik, és mi ezt meg is tettük. A hétköznapi
Googlebot és Applebot ettől nem sérül — külön csoportban vannak, tehát a keresés és a
válaszmotor változatlanul dolgozhat.
2. Link válasz-headerek
Az RFC 8288 szerinti Link: HTTP-fejléc gép-olvasható navigáció: az ügynök
egyetlen fejkérésből megtudja, hol a sitemap, hol az adatkezelési tájékoztató, hol az
ÁSZF — anélkül, hogy végig kellene túrnia a HTML-t. Nálunk így néz ki:
link: </sitemap.xml>; rel="sitemap"
link: </llms.txt>; rel="describedby"; type="text/plain"
link: </adatkezelesi-tajekoztato>; rel="privacy-policy"
link: </szolgaltatasi-feltetelek>; rel="terms-of-service"
A teszt javaslata itt egy rel="api-catalog" volt. Azt kihagytuk — mert nincs
publikus API-nk. Csak olyan relációt tettünk be, ami hivatalosan regisztrált, és létező
oldalra mutat. Ez a különbség a hirdetés és a hazugság között.
3. llms.txt — amit a teszt nem is kért
Érdekes módon a lista nem tartalmazta, pedig ma ez az egyetlen olyan fájl a mezőnyből,
amit tényleg olvasnak. Az /llms.txt egy rövid, gép-olvasható összefoglaló:
ki vagyunk, mit csinálunk, melyek a belépési pontok, hol a jogi anyag. Nagyjából egy
képeslapnyi szöveg, ami megspórolja az ügynöknek, hogy tizennyolc blogcikkből próbálja
kitalálni, mivel foglalkozunk.
Beleírtunk egy sort, ami emberi oldalról is tanulságos: az űrlapjaink bot-védettek, tehát ha ügynökként jársz itt, a kapcsolatfelvételt hagyd a felhasználódra. Az őszinte korlát-közlés is információ.
4. Strukturált adat — a legnagyobb hiány, amit a teszt nem mért
Amikor átnéztük az oldalt, kiderült valami kellemetlen: egyetlen sor schema.org JSON-LD sem volt rajta. Se cégadat, se szolgáltatás-leírás. A teszt ezt nem kérdezte — pedig ma ez az a formátum, amiből a keresők és a válaszmotorok ténylegesen dolgoznak, nem pedig a friss vázlatokból.
Felkerült: Organization (cégadatok az impresszumból — székhely, adószám,
elérhetőség), WebSite és minden oldalon egy WebPage; a főoldalon
pedig a nyolc szolgáltatásunk katalógusa. Egyetlen szabály jár vele, és ez fontosabb, mint
maga a kód: ha az impresszumban változik egy adat, itt is javítani kell.
Az ellentmondó strukturált adat rosszabb, mint a hiánya.
5. A bónusz, ami nem is volt a listán: a jogi oldalak
Munka közben előkerült egy klasszikus hiba, ami valószínűleg minden harmadik magyar
weboldalon ott van. Az ÁSZF-et és az adatkezelési tájékoztatót nem akartuk a
találatokban látni, ezért két dolgot csináltunk annak idején: kitiltottuk őket a
robots.txt-ben, és noindex fejlécet is adtunk nekik.
Ez a kettő kioltja egymást. Amit a robots.txt tilt, azt a robot
le sem tölti — tehát a noindex-et soha nem látja meg. Az
eredmény: a régi találatok bent ragadhatnak, cím és leírás nélkül, és nincs eszközöd
kivenni őket.
A megoldás ellentmond a józan észnek, de ez a működő út: a tiltást kell levenni, hogy a robot bejöhessen és elolvashassa a „ne indexeld" utasítást. Mi ezt tettük, és közben megerősítettük a fejlécet:
X-Robots-Tag: noindex, follow, noarchive, nosnippet
A nosnippet a lényeg ebben az AI-korszakban: a Google saját dokumentációja
szerint az így jelölt tartalom az AI Overviews és az AI Mode válaszaihoz sem
használható fel. Vagyis pontosan azt kaptuk, amit akartunk — a jogi szövegeink
nem kerülnek be sem a találatokba, sem a gépi válaszokba —, miközben a mechanizmus végre
tényleg működik.
6. Markdown az ügynököknek — amit végül saját kézzel építettünk meg
Ez volt az egyetlen pont a listán, amit őszintén akartunk. A lényeg egyszerű: ha egy
ügynök Accept: text/markdown fejléccel kéri az oldalt, akkor tiszta markdownt kap
a HTML helyett. Ugyanaz a tartalom, sokkal kevesebb tokenből — a böngészőnek pedig minden
marad a régiben.
A Cloudflare kínálja is, egyetlen kapcsolóval — de csak fizetős csomagtól felfelé, domainenként. Több mint egy tucat domaint üzemeltetünk; egyetlen checklist-pontért ez nem éri meg a havidíjat mindegyikre. Viszont ez a viselkedés nem a Cloudflare találmánya, hanem szabvány HTTP-tartalomtárgyalás — tehát a saját szerverünkön is megvalósítható. Meg is írtuk:
ugyanaz az oldal, kétféle kéréssel

Accept: text/html      → 89 621 bájt HTML
Accept: text/markdown  → 17 134 bájt Markdown   (-81%)

content-type: text/markdown; charset=utf-8
x-markdown-tokens: 3984
A megoldás a kész HTML-t kapja el, és bejárja a dokumentumot: a navigációt, a láblécet, a süti-sávot és a scripteket eldobja, a címsorokat, listákat, kódblokkokat és linkeket pedig markdownra fordítja — a hivatkozásokat abszolút URL-lé alakítva, hogy a fájl önmagában is használható legyen. Az elejére YAML-fejléc kerül (cím, leírás, kanonikus URL, nyelv). Ha a konverzió bármi miatt elhasalna, a HTML megy ki — egy formázási hiba nem érhet üres oldalt.
Egy részlet, ami sokakat megfog: a Cloudflare a Vary fejlécet az
Accept-Encoding-on kívül nem veszi figyelembe. Ez azt jelenti, hogy
ha az oldal cache-elhető lenne, egy markdown válasz elvben kimehetne egy böngészőnek is.
Ezért a markdown változatot egyszerűen kivettük a cache-elhető körből
(Cache-Control: private, no-store). Ugyanaz a lecke, mint lentebb a
robots.txt-nél: a cache-t nem elég ismerni, számolni kell vele.
Amit szándékosan nem csináltunk meg
És most jön a lista másik fele. Hét pont, amit a teszt hiányként jelöl, és amit egy ügynökség simán le tudna számlázni „AI-optimalizálás" címén. Egyiket sem tettük fel — és a végén még kettő jön, amit egyelőre nyitva hagyunk.
API-katalógus (RFC 9727)
A javaslat: tegyünk ki egy /.well-known/api-catalog fájlt, ami felsorolja az
API-jainkat, az OpenAPI-leírásukat és a health-végpontjukat. Nálunk ebből egy sem létezik:
a webaktivator.hu egy szolgáltatás-oldal, nem egy fejlesztői platform. Egy üres vagy
kitalált katalógus semmit nem old meg, viszont hazudik.
OAuth/OIDC discovery és OAuth Protected Resource
Két külön pont, ugyanaz a válasz. Ezek arra valók, hogy egy ügynök megtudja, hova küldje
a bejelentkezését, ha védett API-t akar hívni. Nincs védett API-nk és nincs
authorization serverünk. Egy sehova nem mutató issuer mező nem pluszpont,
hanem egy törött végpont: az ügynök megpróbálja, hibát kap, és onnantól az egész oldalt
megbízhatatlannak könyveli el. Érdemes észrevenni, hogy maga a javaslat is így kezdődik:
„ha az oldaladnak vannak védett API-jai". A teszt viszont akkor is hiánynak jelöli, ha
nincsenek — ez a pontozás korlátja, nem a te hibád.
auth.md
Ugyanez, egy szinttel feljebb: ez egy ügynök-regisztrációs leírás lenne. Ahhoz előbb olyan szolgáltatásra volna szükség, amire ügynököt lehet regisztrálni.
MCP Server Card
Az MCP (Model Context Protocol) az a szabvány, amin keresztül egy AI-modell külső eszközöket hív. A „server card" azt hirdetné, hogy nálunk fut ilyen szerver. Nem fut. Ez amúgy izgalmas irány — de ez egy terméktervezési döntés, aminek üzleti oka, üzemeltetése és felelőse van, nem pedig egy fájl, amit a pontszámért kiteszünk.
DNS-AID (ügynök-felderítés DNS-ből)
Ez a legdrágább a hét közül. A javaslat szerint speciális DNS-rekordokat kellene publikálnunk, és DNSSEC-cel aláírni a zónát, hogy az ügynökök hitelesítetten találjanak meg minket. A DNSSEC bekapcsolása nem triviális lépés: kézi beavatkozást igényel a domain-regisztrátornál, és rosszul csinálva elérhetetlenné teszi az egész domaint. Mindezt egy korai IETF-vázlatért, amit ma gyakorlatilag senki nem kérdez le — és egy olyan ügynök-szolgáltatásért, ami nálunk nem is létezik. Ez a kockázat és a haszon legrosszabb aránya az egész listán.
WebMCP
Ez volt a legérdekesebb dilemma, mert üzletileg van benne fantázia: a
navigator.modelContext API-val a böngészőben futó ügynök közvetlenül
használhatná az oldal funkcióit — például beküldhetne egy ajánlatkérést.
Csakhogy a mi űrlapjaink bot-védettek, és ez a védelem szándékosan „zárva bukik": ha nincs érvényes emberi ellenőrzés, a beküldés elutasításra kerül. Vagyis ha kitennénk egy ügynöknek szánt „küldj ajánlatkérést" eszközt, az ügynök meghívná, a rendszer pedig visszautasítaná. Ígéret, amit a saját védelmünk cáfol. Vagy-vagy — és most a spamvédelem fontosabb.
Maradt még két opcionális pont — az ARD katalógus és az „agent skills" index. Ezek ártalmatlanok, és lehet, hogy egyszer felkerülnek. De csak valós tartalommal, akkor, amikor lesz mit beleírni. Töltelékből nem lesz felfedezhetőség.
A csavar: a teszt egy ponton nem az oldalunkat mérte
Az első újramérés 22-ről 27-re ment fel — a Link headerek átmentek.
A Content Signals viszont továbbra is hiányzóként jött vissza, pedig a fájl bizonyíthatóan ki volt
téve. Utánamentünk, és ez jött ki:
GET /robots.txt              → cf-cache-status: HIT
                                last-modified: 2026-06-17   ← a JÚNIUSI fájl

GET /robots.txt?cb=8842      → cf-cache-status: MISS
                                (benne a friss Content-Signal sor)
A Cloudflare a .txt fájlokat alapból cache-eli, jellemzően órás
nagyságrendű élettartammal. Mi végig cache-busterrel ellenőriztünk — az a bevált szokás,
amikor a saját deploydat nézed —, és emiatt zöldnek láttuk. A scanner viszont úgy kéri a
fájlt, ahogy bárki más: dísztelenül. És a júniusi példányt kapta.
A tanulság nem az, hogy a teszt rossz. Hanem az, hogy egy mérés mindig egy konkrét kérésre adott konkrét választ mér — és ha nem tudod, milyen kérést küld, akkor nem tudod, mit mértél. Ugyanez a hiba okozza a legtöbb „de nálam jó" vitát fejlesztő és ügyfél között.
A javítás két lépés volt: rövid élettartamot adtunk ezeknek a felderítő fájloknak, hogy a változás percek alatt kimenjen, és kiürítettük a beragadt példányt a cache-ből. Azóta a dísztelen kérés is a friss fájlt kapja — és a következő mérés 33 pont lett. A saját markdown-megoldásunk után pedig 40, „Level 4 — Agent-Integrated".
A végeredmény, kategóriánként
Itt válik igazán beszédessé a pontszám. A teszt öt kategóriában mér, és a végeredményünk pontosan azt a képet rajzolja ki, amiről ez a bejegyzés szól:
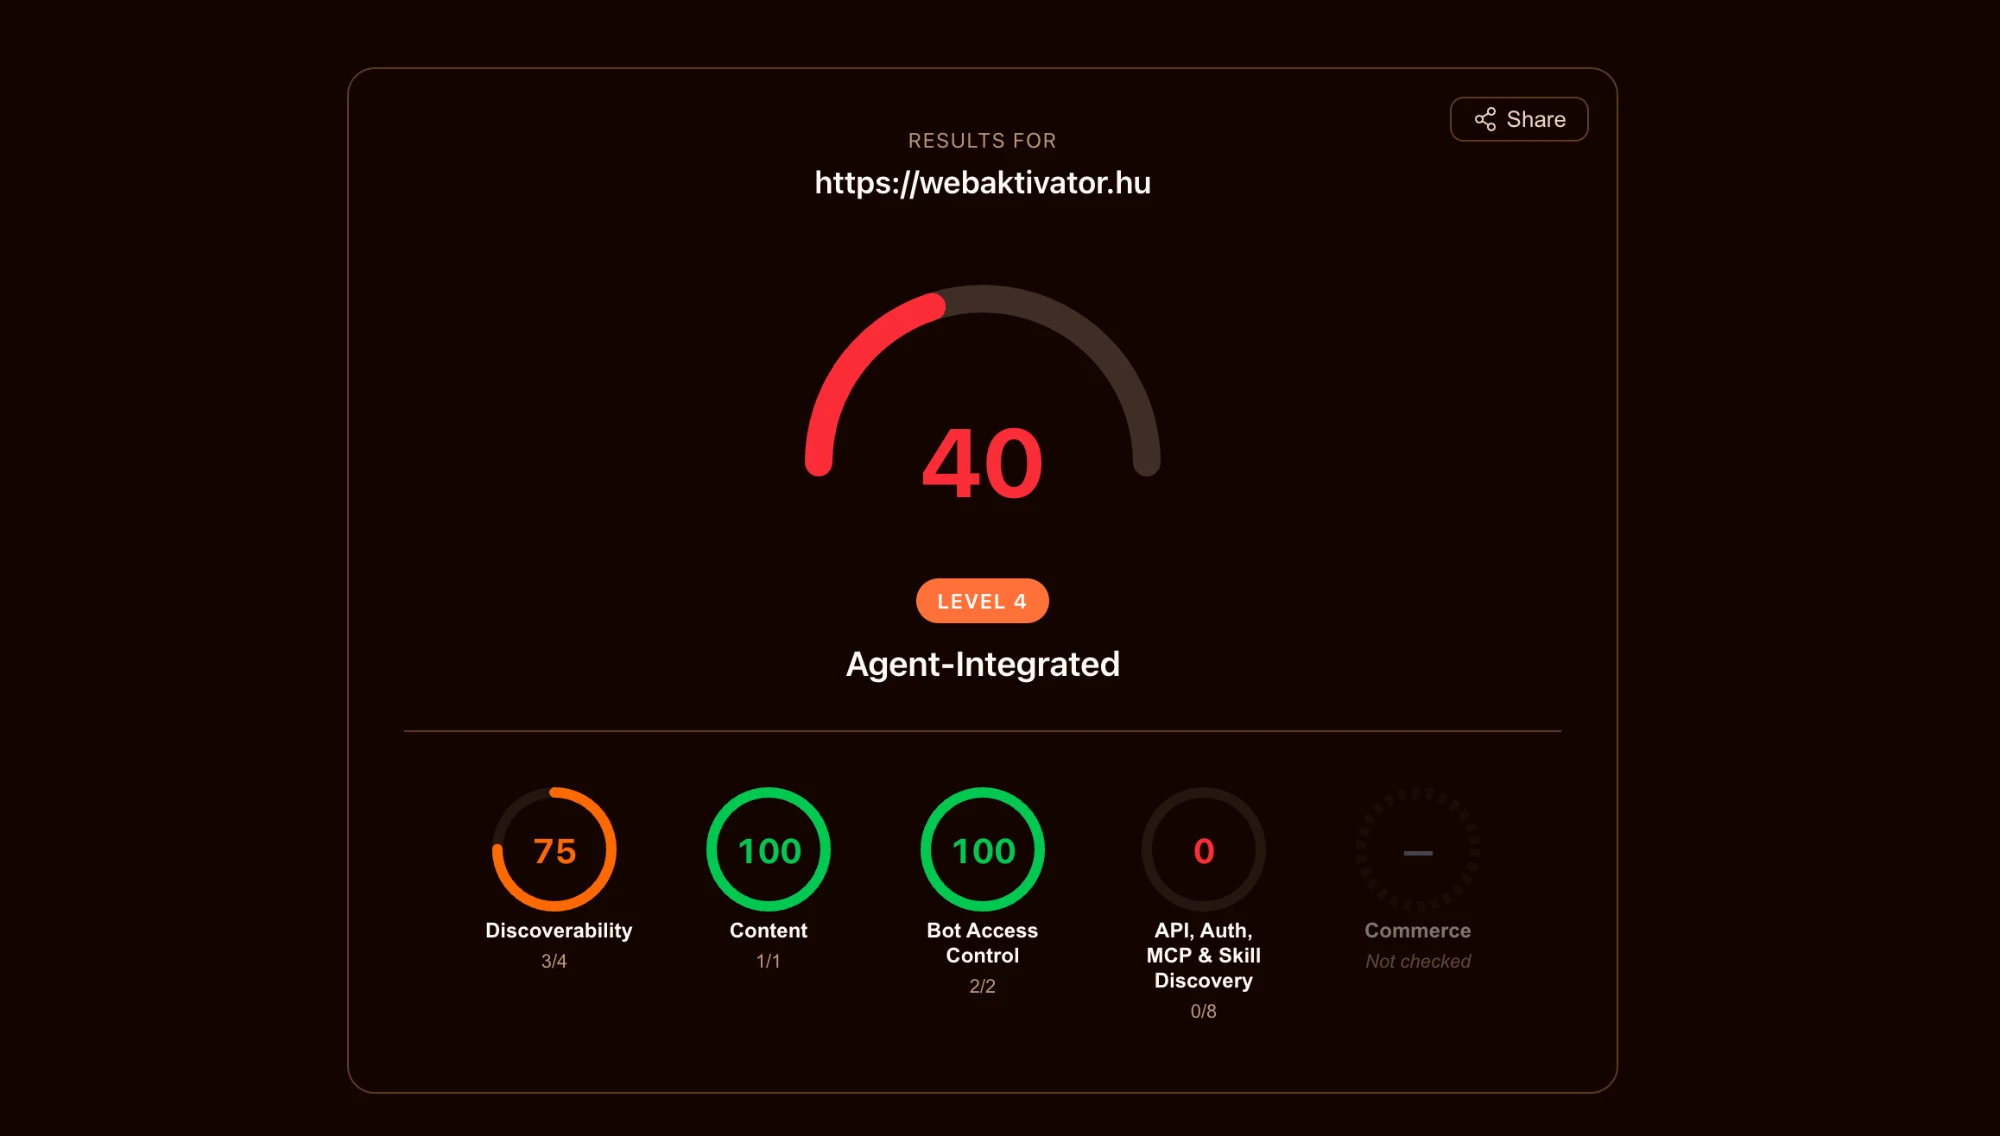
A nyolc pontos „API, Auth, MCP & Skill Discovery" kategória az, ami a pontszámot lehúzza — és ez az a nyolc pont, amit fentebb egyenként megindokoltunk, miért nem teszünk fel. Ha holnap kiraknánk mind a nyolc fájlt, a szám 40-ről a 80-as tartományba ugorna. Az oldal viszont nem lenne jobb, csak hazudósabb: nyolc olyan szolgáltatást hirdetne, ami nem létezik.
Amit viszont fontos észrevenni: Content 100%, Bot Access Control 100%, Discoverability 75%. Ez a három kategória az, ami valódi, ma is működő mechanizmusokat mér — és ezekben gyakorlatilag hiánytalanok vagyunk (a hiányzó egyetlen darab a DNS-AID). A „hiányzó" 60 pont túlnyomó része olyan szabvány-vázlat, amit ma egyetlen éles ügynök sem kérdez le.
Amit a teszt egyáltalán nem mér — pedig ez hozza a legtöbbet
A végén álljunk meg egy pillanatra. Az egész listán egyetlen tétel sem kérdezett rá arra, amiből a mai válaszmotorok ténylegesen dolgoznak:
- Van-e strukturált adatod (schema.org) — nálunk nem volt, ez volt a nap legnagyobb valódi hiánya
- Értelmes-e a HTML szerkezeted — címsor-sorrend, tiszta szövegtörzs, nem div-leves
- Gyors-e az oldal — amit nem tud betölteni, azt nem tudja idézni
- Beengeded-e egyáltalán a válaszmotorokat — sokan tűzfalszinten kizárják őket, aztán csodálkoznak, hogy nem szerepelnek az AI-válaszokban
- Van-e valódi, konkrét tartalmad — nevekkel, számokkal, dátumokkal; ezt idézik, nem a marketing-jelzőket
Ez a szomorú aránypár: a checklist tizenkét pontjából hét semmit nem adott volna, öt hasznos volt — a legnagyobb nyereséget viszont két olyan dolog hozta (strukturált adat, jogi oldalak fejléce), ami rajta sem volt a listán.
Amit elvihetsz
- Futtasd le magadnak az isitagentready.com-on — hasznos, mert kérdéseket tesz fel, amiket magadtól nem tennél fel. Csak ne a pontszámot vidd haza, hanem a kérdéseket.
- Minden javaslatnál kérdezd meg: létezik nálam az, amit ez hirdetne? Ha nem, akkor a felrakása nem javítás, hanem hibaforrás.
- Kezdd a robots.txt-tel. Egy sor Content Signal, tudatos döntéssel: keresés igen, AI-válasz igen, tréning ahogy jónak látod.
-
Nézd meg a jogi oldalaidat. Ha
Disallowésnoindexegyszerre van rajtuk, akkor anoindexnem működik. - Tedd fel a strukturált adatot, ha még nincs. Ez hozza a legtöbbet, és egyik teszt sem fogja megdicsérni érte.
- Ellenőrzésnél tudd, mit mérsz. Cache-buszterrel a saját deploydat látod; a világ a cache-elt választ kapja. Mindkettőt nézd meg.
A saját mércénk ebben a munkában végig ez volt: a működésre optimalizálunk, nem a pontszámra. Egy magasabb szám bármikor megvásárolható tíz fájllal, amit soha senki nem hív le. Az viszont, hogy egy AI-válaszban téged idézzenek, azon múlik, hogy érthető, gyors és igaz-e, amit kiteszel.
Benkó János · webaktivátor
16 éve értékesít, 2014 óta weboldalakat üzemeltet és hirdetéseket kezel. Ki az a Benkó János? →
Akadálypálya helyett sportautó. Nézzük meg együtt, hol szivárog el a költésed.
Szivárgás-audit →